
Co to jest llama.cpp
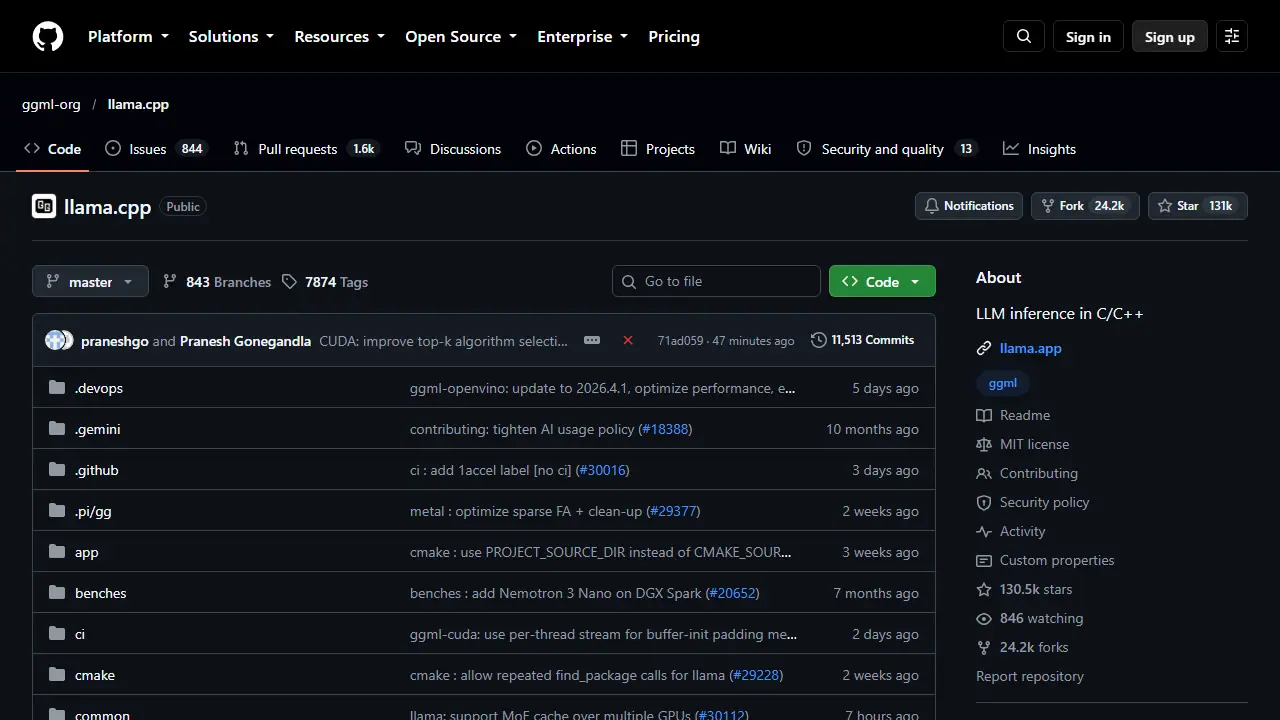
llama.cpp to projekt open source napisany w C/C++, który umożliwia wnioskowanie (inference) z dużych modeli językowych i wizyjno-językowych (LLM i VLM) przy minimalnej konfiguracji. Celem projektu jest uruchamianie modeli na zwykłym sprzęcie, bez zależności od chmury, wykorzystując format GGUF.
Narzędzie instaluje się skryptem, pobraniem gotowych binariów, uruchomieniem przez Docker albo kompilacją ze źródeł. Po instalacji możesz pobrać model z Hugging Face jednym poleceniem i rozmawiać z nim w terminalu (llama cli), albo uruchomić serwer zgodny z API OpenAI (llama serve) z wbudowanym interfejsem webowym.
Co potrafi
- Uruchamianie modeli LLM i VLM lokalnie
- Pobieranie modeli bezpośrednio z Hugging Face
- Serwer REST zgodny z API OpenAI
- Wbudowany interfejs webowy
- Wnioskowanie w C/C++ z minimalnymi zależnościami
Dla kogo
- Programiści integrujący modele lokalnie
- Osoby chcące pracować na modelach bez wysyłania danych do chmury
- Badacze i entuzjaści lokalnych LLM
Jak zacząć z llama.cpp
- Zainstaluj llama.cpp skryptem, gotowym binarium, Dockerem lub kompilacją
- Pobierz model w formacie GGUF z Hugging Face jednym poleceniem
- Uruchom rozmowę w terminalu przez llama cli albo serwer llama serve
- Chcesz uruchamiać modele językowe lokalnie, bez wysyłania danych do chmury
- Potrzebujesz serwera zgodnego z API OpenAI do integracji z własnym kodem
- Tworzysz integracje w C/C++ z minimalnymi zależnościami
- Szukasz gotowego interfejsu z polskim językiem, bo ten nie jest dostępny
- Nie chcesz samodzielnie pobierać i konfigurować modeli oraz sprzętu
Plusy i minusy
- Działa lokalnie, bez zależności od zewnętrznych usług
- Kompatybilny z API OpenAI
- Otwarte źródło na licencji MIT
- Wymaga pobrania i konfiguracji modeli oraz odpowiedniego sprzętu
Ile kosztuje llama.cpp
| Plan | Cena | Co daje |
|---|---|---|
| Open source (MIT) | 0 USD | darmowa biblioteka i serwer do lokalnego uruchamiania modeli |
Ceny przepisane z: cennik llama.cpp, stan na 12 października 2026. Waluta jak w cenniku producenta, ceny mogą nie zawierać VAT.
Szczegóły: llama.cpp - cena i plany.
Czy jest za darmo?
Tak, ma darmowy plan. llama.cpp jest w pełni darmowy na licencji MIT - płacisz tylko za własny sprzęt.
llama.cpp za darmo - co daje plan bez opłat
Czy działa po polsku?
Strona narzędzia jest po angielsku i producent nie wymienia polskiego wprost. Sprawdź na darmowym planie, jak radzi sobie z polskim tekstem.
Gdzie działa
web, api, linux, windows, mac. Ma API.
Alternatywy dla llama.cpp
| Narzędzie | Cena od | Za darmo | Po polsku | Kategoria |
|---|---|---|---|---|
 1X NEO | 200 USD | nie | ? | Lokalne i open source |
 RunThisLLM | brak w cenniku | tak | ? | Lokalne i open source |
 llmrun | brak w cenniku | ? | ? | Lokalne i open source |
| Hhallmonitor | brak w cenniku | tak | ? | Produktywność i notatki |
 Google DeepMind | brak w cenniku | ? | ? | Inne |
Wszystkie alternatywy dla llama.cpp →
Najczęstsze pytania
Do czego służy llama.cpp?
Otwartoźródłowa biblioteka C/C++ do uruchamiania dużych modeli językowych (LLM) lokalnie, na własnym sprzęcie.
Czy llama.cpp jest darmowy?
Tak, ma darmowy plan. llama.cpp jest w pełni darmowy na licencji MIT - płacisz tylko za własny sprzęt.
Ile kosztuje llama.cpp?
Producent nie podaje cen publicznie albo cennik wymaga zalogowania.
Czy llama.cpp działa po polsku?
Strona narzędzia jest po angielsku i producent nie wymienia polskiego wprost. Sprawdź na darmowym planie, jak radzi sobie z polskim tekstem.
Jakie są alternatywy dla llama.cpp?
Najbliższe zamienniki: 1X NEO, RunThisLLM, llmrun, hallmonitor, Google DeepMind.
Dane sprawdzone 8 października 2026 na stronie producenta (github.com). Widzisz błąd? Napisz: kontakt@dobieracz.pl.